
Illustration: Louiza Karageorgiou for GIJN
(संपादकीय टिप्पणी : पुलित्ज़र सेंटर की एआई जवाबदेही टीम और जीआईजेएन के बीच सहयोग के आधार पर यह गाइड बनाई गई है। इसकी कुछ सामग्री कैरेन हाओ, लाइस मार्टिंस और पाब्लो जिमेनेज़ अरंडिया ने मिलकर तैयार की है।)
अब समाज के कई क्षेत्रों में आर्टिफिशियल इंटेलिजेंस (एआई) एक बड़ी ताकत बन चुका है। कई अर्थव्यवस्थाओं में इसकी बड़ी भूमिका है। दुनिया भर में ज्ञान-आधारित काम करने वालों पर इसका असर पड़ा है। एआई क्षेत्र में ज़्यादातर बड़ी कंपनियां अमेरिका, यूरोप या चीन की हैं। इनमें से कई निजी ‘बिग टेक’ कंपनियां हैं। इन्हें अरबों का निवेश मिल रहा है। यही कम्पनियाँ तय कर रही हैं कि एआई को दुनिया भर में कैसे विकसित और लागू किया जाएगा।
लेकिन अपनी सप्लाई चेन से लेकर अपने इस्तेमाल तक एआई ने काफी विवाद भी पैदा किए हैं। एआई को विकसित करने वाले डेटा सेंटर बहुत ज़्यादा पानी और ऊर्जा की खपत कर रहे हैं। एआई के लिए ज़रूरी डेटा को लेबल करने वाले वर्कर कम वेतन और मानसिक स्वास्थ्य की समस्याओं से जूझ रहे हैं। खुद एआई तकनीकें भी इस्तेमाल के दौरान पक्षपाती और ‘हैलुसिनेट’ (गलत या मनगढ़ंत जानकारी देने वाली) साबित हुई हैं।
एआई के क्षेत्र में खोजी पत्रकारों के लिए अनगिनत कहानियों का खजाना है। यह गाइड पत्रकारों को एआई के पीछे की टेक्नोलॉजी की बारीकियां बताएगी। इसकी जांच-पड़ताल के लिए आपको एक फ़्रेमवर्क मिल जाएगा।
एआई क्या है?
पहली बार चैट-जीपीटी के ज़रिए बहुत से लोगों को एआई के बारे में जानकारी मिली। इसलिए लोग चैट-जीपीटी को ही एआई और एआई को महज चैट-जीपीटी समझते हैं।
लेकिन असलियत काफी जटिल है। आर्टिफिशियल इंटेलिजेंस का मतलब है मशीनों का इस्तेमाल करके इंसानों की तरह फ़ैसले लेने की क्षमता की नकल करना। इसे कई तकनीक को एक साथ समेटने वाले एक व्यापक शब्द या “ग्रैब बैग” के तौर पर समझा जा सकता है।
वैज्ञानिकों और शोधकर्ताओं ने 1950 के दशक में यह शब्द गढ़ा था। तब से उन्होंने तकनीक के ज़रिए इंसानी बुद्धिमत्ता को फिर से बनाने के कई अलग-अलग तरीके खोजे हैं।
आजकल एआई के सबसे अधिक इस्तेमाल होने वाले तरीकों में से एक ‘मशीन लर्निंग’ है। इसमें इसके सभी रूप (जैसे ‘डीप लर्निंग’ और ‘जेनरेटिव एआई’) शामिल हैं।
मशीन लर्निंग क्या है? यह डेटा को एनालाइज़ करके ऐसे पैटर्न खोजने की प्रक्रिया है, जिनकी मदद से हम उन नतीजों के आधार पर अनुमान लगाते या फ़ैसले लेते हैं। इन एनालिसिस में कई तरह के गणितीय तरीकों का इस्तेमाल होता है। जैसे, आसान सांख्यिकी से लेकर जटिल न्यूरल नेटवर्क तक। ऐसे तरीके अक्सर प्रोसेस किए जा रहे डेटा की मात्रा पर निर्भर करते हैं। इस ट्रेनिंग का नतीजा एक कंप्यूटर प्रोग्राम या एआई मॉडल होता है। वह नया डेटा लेकर पुराने डेटा के आधार पर अनुमान लगाता और नई जानकारी बनाता है। मशीन लर्निंग के आउटपुट को आप पुराने डेटा का रीमिक्स मान सकते हैं। जैसे, सरकारी एजेंसियां आसान मशीन लर्निंग मॉडल का उपयोग करके कल्याणकारी योजनाओं के लाभार्थियों को रिस्क स्कोर दे सकती हैं।
डीप लर्निंग क्या है? यह भी मशीन लर्निंग का हिस्सा है। इसमें बहुत अधिक डेटा (अक्सर लाखों में) की ज़रूरत होती है। इसमें डेटा को समझने के लिए न्यूरल नेटवर्क जैसे जटिल एनालिटिकल तरीकों का इस्तेमाल होता है। न्यूरल नेटवर्क गणितीय तरीके हैं। यह इंसानी दिमाग की नकल करके आपस में जुड़े नोड्स से बनते हैं। (आप न्यूरल नेटवर्क के बारे में यहाँ और जान सकते हैं)। बड़ी टेक कंपनियां ऐसी मशीन लर्निंग का इस्तेमाल सर्च इंजन में शब्दों का अनुमान लगाने या स्ट्रीमिंग सर्विस के लिए रिकमेंडेशन सिस्टम बनाने में करती हैं।
जेनरेटिव एआई क्या है? यह भी मशीन लर्निंग का ही एक हिस्सा है। इसे और भी ज़्यादा डेटा की ज़रूरत होती है। इसके मॉडल बनाने के लिए ट्रेनिंग के दौरान बहुत ज़्यादा एनर्जी और जटिल गणितीय तरीकों का इस्तेमाल होता है। जेनरेटिव एआई मशीन लर्निंग के अन्य तरीकों से अलग है। यह सिर्फ़ टाइमलाइन के लिए कोई रिकमेंडेशन या अनुमानित स्कोर नहीं देता, बल्कि टेक्स्ट या इमेज के रूप में नया कंटेंट भी बनाता है। इसी टेक्नोलॉजी से हम आज लार्ज लैंग्वेज मॉडल (एलएलएम) के ज़रिए चैट-जीपीटी या जेमिनी जैसे चैटबॉट और मीड-जर्नी जैसे ऐप्स के ज़रिए देखते हैं। ये टेक्स्ट के प्रॉम्प्ट से इमेज बनाते हैं।
नीचे डायग्राम में मशीन लर्निंग के सभी वर्ज़न दिखाए गए हैं।
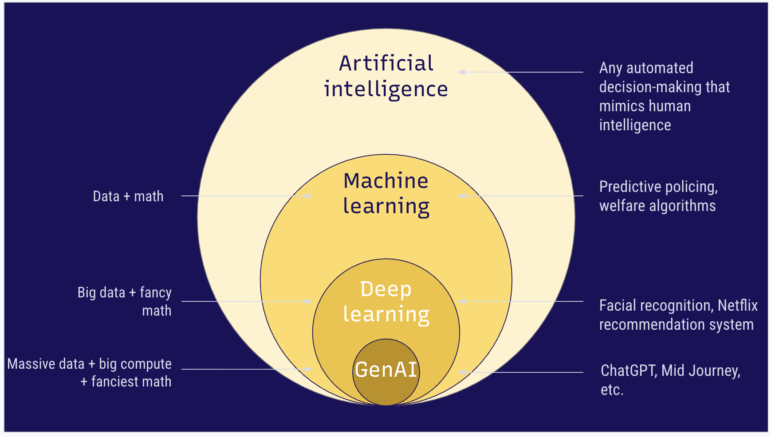
फोटो: आर्टिफिशियल इंटेलिजेंस और उसके सब-सेट (जैसे मशीन लर्निंग, डीप लर्निंग और जेनरेटिव एआई) की ग्राफिकल प्रस्तुति। इमेज: पुलित्ज़र सेंटर के सौजन्य से।
पत्रकारों के पास इस बात की सामान्य जानकारी होनी चाहिए कि मशीन लर्निंग कैसे काम करती है। इससे आपको को इस पर बात करने, तकनीक संबंधी सही सवाल पूछने और रिपोर्टिंग के लिए एआई डेवलपमेंट के विभिन्न चरणों का बेहतर इस्तेमाल करने में मदद मिलेगी।
एआई जवाबदेही से जुड़ी खबरों का फ्रेमवर्क
हमने, कैरेन हाओ के साथ एआई स्पॉटलाइट सीरीज़ बनाई। इसे आरंभ करते समय हमने बार-बार एक ही सवाल पर विचार किया। यह कि, जब हमने पहली बार एआई पर रिपोर्टिंग शुरू की थी, तब हमें क्या पता होना चाहिए था? इसका जवाब था— एआई स्टोरीज़ की पहचान करने और उन्हें तैयार करने का एक फ्रेमवर्क।
एआई में कई तरह की टेक्नोलॉजी और मुद्दे शामिल हैं। यह समझना मुश्किल है कि शुरुआत कहां से करें। हमारा फ़्रेमवर्क मॉडर्न एआई डेवलपमेंट के चार चरणों पर आधारित है। सबसे नीचे इनपुट होते हैं। यानी डेटा और कंप्यूटिंग पावर, जो आज के सिस्टम को मुमकिन बनाते हैं। इसके बाद डेटा और डिज़ाइन के आधार पर मॉडल बनाए और प्रशिक्षित किए जाते हैं। आखिर में, इन मॉडलों का असल दुनिया में इस्तेमाल किया जाता है। डेवलपमेंट के हर चरण से जुड़े मुद्दे, इसमें शामिल लोग और प्रभावित होने वाले लोग या सिस्टम होते हैं।
हम इन सभी चरणों के बारे में बात करेंगे। मुख्य अवधारणा और खास उदाहरणों पर भी चर्चा करेंगे।
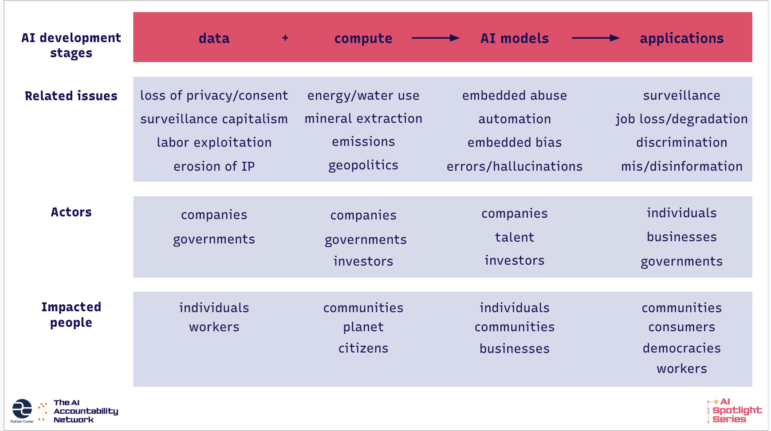
स्क्रीनशॉट : एआई जवाबदेही रिपोर्टिंग फ़्रेमवर्क का ग्राफिक रूप। पुलित्ज़र सेंटर के सौजन्य से
इस्तेमाल किए गए डेटा की जांच
सबसे आसान एआई मॉडल में महज कुछ सौ डेटा पॉइंट वाले ट्रेनिंग सेट से काम चल जाता है। लेकिन एलएलएम जैसे सबसे जटिल मॉडल अक्सर इंटरनेट के बहुत बड़े हिस्से पर ट्रेन किए जाते हैं। ट्रेनिंग डेटा में मौजूद जानकारी का दायरा भी बहुत बड़ा हो सकता है। यह रो (पंक्ति) और कॉलम में अच्छी तरह से व्यवस्थित संरचना के साथ टेबल वाले डेटा के रूप में हो सकता है। यह सोशल मीडिया प्लेटफ़ॉर्म, न्यूज़ साइट और ऑनलाइन फ़ोरम से इकट्ठा किया गया सामान्य टेक्स्ट भी हो सकता है। आजकल इसमें इमेज और वीडियो भी शामिल होते हैं।
डेटा डेवलपमेंट के बारे में ज़्यादातर खबरें उन एडवांस्ड सिस्टम्स पर केंद्रित होती है, जिन्हें बड़े पैमाने पर विशाल डेटासेट के साथ प्रशिक्षित किया जाता है। कुछ खबरें प्राइवेसी और इंटेलेक्चुअल प्रॉपर्टी से जुड़े मुद्दों पर होती हैं। जैसे, कॉपीराइट वाली सामग्री या पर्सनल डेटा किस तरह एआई मॉडल के ट्रेनिंग पाइपलाइन में पहुंच जाता है। ‘द अटलांटिक’ की इस स्टोरी का उदाहरण देखें। इसमें बताया गया है कि मेटा ने किस तरह कथित तौर पर अपने जेनरेटिव एआई मॉडल ‘लामा’ को प्रशिक्षित करने के लिए हज़ारों पायरेटेड किताबों का इस्तेमाल किया। मेटा के एक प्रवक्ता ने कंपनी के खिलाफ चल रहे मुकदमे का हवाला देते हुए ‘द अटलांटिक’ के पत्रकारों को कोई भी जवाब देने से इंकार कर दिया।
‘द न्यूयॉर्क टाइम्स’ की एक स्टोरी में बताया गया कि कार इंश्योरेंस कंपनियां ड्राइवरों के रिस्क-स्कोर का पता लगाने के लिए बेहद सामान्य लगने वाले ऐप्स से ड्राइवरों का पर्सनल ड्राइविंग डेटा खरीद रही हैं ।
लेकिन डेटा को देखने का मतलब इंसान की उस मेहनत को देखना भी है, जो ट्रेनिंग डेटासेट को इस्तेमाल के लायक बनाती है। कंपनियां अक्सर अपने डेटा कलेक्शन और ट्रेनिंग को ऑटोमैटिक प्रोसेस के तौर पर दिखाती हैं। लेकिन असलियत यह है कि ट्रेनिंग सेट को अक्सर डेटा लेबलर्स का एक बड़ा वर्ग साफ और कैटेगराइज़ करता है। ये लोग ज़्यादातर ग्लोबल साउथ में होते हैं, जो आउटसोर्सिंग फर्मों और डिजिटल लेबर प्लेटफॉर्म के ज़रिए काम करते हैं। ये वर्कर बिल्लियों और कुत्तों की तस्वीरों को लेबल करते हैं, जिन्हें इमेज क्लासिफायर में डाला जाता है। साथ ही, सेल्फ-ड्राइविंग कारों को प्रशिक्षित करने के लिए इस्तेमाल होने वाले डैशकैम फुटेज में चीज़ों के चारों ओर बॉक्स बनाते हैं। ये लोग हेट स्पीच और हिंसक कंटेंट की पहचान करते हैं ताकि एलएलएम उन्हें दोहरा न सकें।
दुनिया भर से आई रिपोर्ट बताती हैं कि डेटा वर्करों का शोषण होता है। उन्हें कम पैसे मिलते हैं। कई बार उन्हें सदमा देने वाले कंटेंट के साथ काम के लिए मजबूर किया जाता है। ‘ब्यूरो ऑफ़ इन्वेस्टिगेटिव जर्नलिज़्म’ की इस जांच से पता चलता है कि कैसे दुनिया भर में कम पैसे पाने वाले गिग वर्कर अनजाने में फेशियल रिकग्निशन सिस्टम को प्रशिक्षित कर रहे हैं, जिनका इस्तेमाल रूसी सरकार करती है । ‘अफ्रीका अनसेंसर्ड’ की एक स्टोरी में तेज़ी से बढ़ रहे ‘एआई ट्यूटर’ इंडस्ट्री की पड़ताल की गई। इसमें बहुत पढ़े-लिखे वर्कर एलएलएम चैटबॉट को बेहतर क्वालिटी के जवाब देने के लिए प्रशिक्षित करते हैं।
कंप्यूट की पड़ताल
कंप्यूट क्या है? पहले ट्रेनिंग डेटासेट इकट्ठा करके साफ किया जाता है। फिर कंपनियां उनका इस्तेमाल एआई मॉडल को प्रशिक्षित करने के लिए करती हैं। किसी साधारण एआई मॉडल को लैपटॉप पर कुछ ही सेकंड में प्रशिक्षित किया जा सकता है। लेकिन ओपेन-एआई के चैट-जीपीटी जैसे जटिल मॉडल के लिए बहुत ज़्यादा कंप्यूटिंग पावर की ज़रूरत होती है। इस कंप्यूटिंग पावर को कंप्यूट’ कहा जाता है। आमतौर पर इसे बड़े डेटा सेंटरों में लगे खास कंप्यूटर चिप्स से हासिल किया जाता है।
कंप्यूट’ डेवलपमेंट स्टेज संबंधी खबरें अक्सर आधुनिक एआई डेवलपमेंट को चलाने वाली भौतिक अधिसंरचना के पर्यावरण, समाज और अर्थव्यवस्था पर पड़ने वाले असर पर केंद्रित होती हैं। हमने 2024 में पहली बार एआई स्पॉटलाइट सीरीज़ शुरू की थी। उस वक्त डेटा सेंटर का एक नया विषय था। तब से, लैटिन अमेरिका, एशिया, अफ्रीका और अमेरिका से अनगिनत खबरें आई हैं। इनमें दिखाया गया है कि डेटा सेंटर भारी मात्रा में ऊर्जा और पानी की खपत करते हैं। साथ ही, कंपनियां और सरकारें इन आंकड़ों को छिपाने की कोशिश करती हैं। ब्राज़ील में पुलित्ज़र फेलो लाइस मार्टिंस ने पाया कि टिकटॉक के एक डेटा सेंटर में उतनी बिजली इस्तेमाल होता था, जितनी 22 लाख लोग करते हैं। कंपनी ने रिपोर्टर को कोई जवाब नहीं दिया।
डेटा सेंटर्स संबंधी खबरें पर्यावरण पर उनके असर तक सीमित नहीं है। इसमें कई अन्य पहलुओं को भी देखा जाता है। जैसे, डेटा सेंटर्स स्थानीय समुदायों को कैसे बदलते हैं, आर्थिक विकास के अधूरे वादे, और डेटा सेंटर्स के लिए ज़बरदस्त लॉबिंग की कोशिशें कैसे होती हैं। लाइस और पाब्लो जिमेनेज़ अरंडिया ने हमारे फ़्रेमवर्क का एक बदला हुआ प्रारूप तैयार किया है। यह सिर्फ़ डेटा सेंटर रिपोर्टिंग पर केंद्रित है। इसे आप नीचे देख सकते हैं।
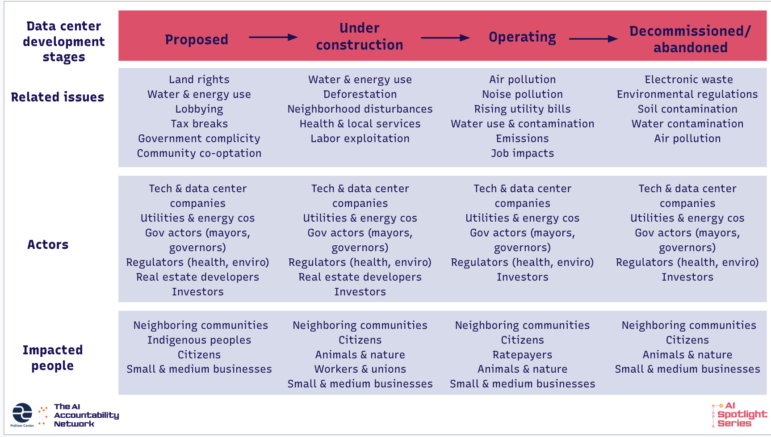
इमेज : पुलित्ज़र सेंटर के सौजन्य से
मॉडलों की पड़ताल
ट्रेनिंग डेटा और कंप्यूट के मेल से एक एआई मॉडल बनता है। यह एक तकनीकी चीज़ है जो अनुमान लगाती है, चीज़ों को अलग-अलग श्रेणी में बांटती है। जेनरेटिव एआई के मामले में यह पूरी तरह से नया कंटेंट बनाती है। डेटा और कंप्यूट की तरह ही, एआई मॉडलों की जटिलता और पैमाना भी अलग-अलग होता है। इनमें हेल्थकेयर प्रीमियम का हिसाब लगाने वाले अपेक्षाकृत आसान मशीन लर्निंग सिस्टम से लेकर, असली जैसी तस्वीरें बनाने में सक्षम एडवांस्ड डीप लर्निंग सिस्टम तक शामिल हैं।
एआई मॉडल पर आधारित खबरों में अक्सर भेदभाव, गलतियों या समुदायों और संस्थाओं पर ऑटोमेशन के बुरे असर जैसे मुद्दों पर ध्यान दिया जाता है।
ऐसी जांच-पड़ताल में मॉडल के डिज़ाइन से जुड़े पहलुओं की बारीकी से जांच की जा सकती है। जैसे, उसमें इस्तेमाल किया गया ट्रेनिंग डेटा या पैरामीटर। उदाहरण के लिए, El Confidencial की एक जांच में कैटलन जेल सिस्टम में इस्तेमाल होने वाले एआई सिस्टम का फ़ॉर्मूला पता लगाया गया। इसमें यह अनुमान लगाया जाता था कि भविष्य में कौन अपराध करेगा। पत्रकारों के अनुसार, यह मॉडल भेदभावपूर्ण या गैर-ज़रूरी वजहों के आधार पर कुछ खास समूहों को लगातार ज़्यादा रिस्क स्कोर देता था।
जब ऐसी जानकारी उपलब्ध न हो, तो आप मॉडल के आउटपुट का विश्लेषण कर सकते हैं। Rest of World की एक स्टोरी का उदाहरण देखें। इसने इमेज बनाने वाला एक लोकप्रिय टूल MidJourney AI से तैयार की गई 3,000 इमेज का विश्लेषण किया गया। इसमें पाया गया कि यह सिस्टम विभिन्न संस्कृतियों के बारे में अपमानजनक स्टीरियोटाइप यानी रूढ़िवादी धारणाओं को दोहराता है। इस स्टोरी के मुताबिक कंपनी ने उनके सवालों का कोई जवाब नहीं दिया। एक अन्य जांच ‘फिलीपीन सेंटर फॉर इन्वेस्टिगेटिव जर्नलिज्म’ (पीसीआईजे) ने की। इसमें राइड-हेलिंग ऐप ‘ग्रैब’ के किराये के अनुमान इकट्ठा करके उसके एल्गोरिदम आउटपुट का रिवर्स-इंजीनियरिंग के ज़रिए विश्लेषण किया गया। इसमें पाया गया कि ‘ग्रैब’ ग्राहकों से हमेशा अतिरिक्त शुल्क वसूल रहा था। जबकि यह सिर्फ़ भारी ट्रैफ़िक वाले समय में ही लागू होनी चाहिए। पीसीआईजे को दिए जवाब में ‘ग्रैब’ के फिलीपीन ऑपरेशन्स ने कहा कि उसने सुनवाई में हिस्सा लेकर लैंड ट्रांसपोर्टेशन फ्रैंचाइज़िंग एंड रेगुलेटरी बोर्ड की जांच में पूरा सहयोग किया है।
एप्लिकेशंस की जांच
पत्रकारों के लिए यह देखना ज़रूरी है कि असल दुनिया में आर्टिफिशियल इंटेलिजेंस का इस्तेमाल कैसे किया जा रहा है। जब एआई टेक्नोलॉजी उम्मीद के मुताबिक काम नहीं करती या उसमें कोई खराबी आती है, तो एल्गोरिदम या जेनरेटिव एआई ऐप्स जैसे ऑटोमेटेड सिस्टम से लिए गए फैसलों से कई लोगों को नुकसान हो सकता है।
‘द गार्डियन’ में रिपोर्टर जोहाना भुइयां की एक स्टोरी देखें। इसमें दिखाया गया है कि कैसे एआई ट्रांसलेशन ऐप्स पर अमेरिकी सरकार के बहुत ज़्यादा भरोसा करने की वजह से एक शरण चाहने वाला व्यक्ति छह महीने तक आईसीई डिटेंशन सेंटर में फंसा रहा। कम रिसोर्स वाली भाषाओं में खराब परफॉर्मेंस देने वाले उस ऐप ने उसकी बातों का गलत अनुवाद किया। इससे वह किसी से भी ठीक से बातचीत नहीं कर पाया। डीएचएस ने ‘द गार्डियन’ रिपोर्टर के सवालों का कोई जवाब नहीं दिया।
भारत सरकार द्वारा फेशियल रिकग्निशन (चेहरा पहचानने वाली टेक्नोलॉजी) के इस्तेमाल पर हेरा रिज़वान की स्टोरी का उदाहरण देखें। इसमें पता चला कि गरीबों को राशन देने के लिए सरकार जिस ऐप का इस्तेमाल करती है, वह कुछ गर्भवती या स्तनपान कराने वाली महिलाओं को पहचानने में नाकाम रहा। उनके चेहरे सरकारी डेटाबेस में कई साल पहले स्टोर की गई तस्वीरों से अलग दिख रहे थे। महिला एवं बाल विकास मंत्रालय ने रिज़वान के सवालों का कोई जवाब नहीं दिया।
एआई जवाबदेही पर रिपोर्टिंग
ऊपर दिए गए उदाहरण महत्वपूर्ण हैं। इनसे पता चलता है जवाबदेही का ढांचा पत्रकारों को तकनीकी मेहनत और संसाधनों के साथ एआई पर रिपोर्ट करने में मदद कर सकता है। खबरें छोटी या लंबी हो सकती हैं। वे ज़्यादातर इंसानों पर आधारित या ज़्यादातर तकनीकी रूप से तैयार की गई हो सकती हैं। हमें उम्मीद है कि इन तरीकों और उदाहरणों से पत्रकारों को एआई जवाबदेही रिपोर्टिंग के लिए अपना स्थानीय तरीका खोजने में मदद मिलेगी।
संसाधन
- पत्रकारों के लिए एल्गोरिदम की समझ : Algorithmic Literacy for Journalists: पत्रकारों के लिए जानकारी देने वाले लेख और अन्य संसाधन।
- एआई स्पॉटलाइट सीरीज़ ओपन-सोर्स करिकुलम : AI Spotlight Series Open-Sourced Curriculum) : इसमें पत्रकारों को एआई के बारे में शिक्षित करने के लिए पुलित्ज़र सेंटर की पहल से वीडियो ट्यूटोरियल , फ्रेमवर्क और स्लाइड डेक शामिल हैं।
- एआई से बने कंटेंट का पता लगाने के लिए पत्रकारों के लिए गाइड : Reporter’s Guide to Detecting AI-Generated Content
- सोशल मीडिया एल्गोरिदम की जांच के लिए गाइड : Guide to Investigating Social Media Algorithms
रिसर्च
- Algorithmic Justice League : यह एल्गोरिदम से होने वाले नुकसान का दस्तावेज़ीकरण और जांच करने वाली संस्था है।
- AI Now Institute: यह एआई और एल्गोरिदम की जवाबदेही के बारे में रिसर्च प्रकाशित करने वाला स्वतंत्र संस्थान है।
- Center for Democracy and Technology : यह डिजिटल युग में नागरिक स्वतंत्रता पर रिपोर्ट जारी करने वाला एनजीओ है।
- Data and Society : टेक्नोलॉजी, डेटा और नीतियों पर केंद्रित रिसर्च करने वाला एनजीओ।
- Algorithm Watch : ज्यूरिख और बर्लिन में स्थित एक गैर-लाभकारी समूह।
- Privacy International : लंदन में स्थित एक गैर-लाभकारी समूह।
- Derechos Digitales : लैटिन अमेरिका पर केंद्रित डिजिटल अधिकारों के लिए काम करने वाली एक गैर-लाभकारी संस्था।
- African Digital Rights Network : यह पूरे अफ्रीका में काम करने वाली डिजिटल अधिकारों की संस्था है।
 गेब्रियल गाइगर : एथेंस (ग्रीस) निवासी खोजी पत्रकार, जो निगरानी और एल्गोरिदम की जवाबदेही से जुड़ी रिपोर्टिंग करते हैं। अभी नीदरलैंड की गैर-लाभकारी मीडिया संस्थान ‘लाइटहाउस रिपोर्ट्स’ में खोजी पत्रकार के बतौर काम कर रहे हैं। उनके काम WIRED, Le Monde, Der Spiegel और The Guardian जैसे कई प्रकाशनों में छपे हैं।
लैम थुई वो : जमीनी रिपोर्टिंग के साथ डेटा विश्लेषण को जोड़कर यह अध्ययन करती हैं कि व्यवस्थाएं और नीतियां व्यक्तियों को कैसे प्रभावित करती हैं। अभी वह डॉक्यूमेंटेड नामक एक स्वतंत्र, गैर-लाभकारी समाचार एजेंसी में खोजी पत्रकार के रूप में कार्यरत हैं, जो आप्रवासी समुदायों के साथ और उनके लिए रिपोर्टिंग करने के लिए समर्पित है। वह क्रेग न्यूमार्क ग्रेजुएट स्कूल ऑफ जर्नलिज्म में डेटा जर्नलिज्म की एसोसिएट प्रोफेसर भी हैं। वह द मार्कअप, बज़फीड न्यूज़, द वॉल स्ट्रीट जर्नल, अल जज़ीरा अमेरिका और एनपीआर के प्लैनेट मनी में पत्रकार रह चुकी हैं।
अनुवाद : डॉ. विष्णु राजगढ़िया
भुखमरी और खाद्य असुरक्षा की जांच के लिए गाइड
चीनी कंपनियों की जांच के लिए ओपन सोर्स गाइड
AI का उपयोग करके तैयार किए गए कंटेंट का पता कैसे लगाएं
सोशल मीडिया एल्गोरिदम की जांच कैसे करें
15वीं ग्लोबल इन्वेस्टिगेटिव जर्नलिज्म कॉन्फ्रेंस की तारीखों की घोषणा के साथ वेबसाइट आरंभ
विभिन्न सोशल मीडिया प्लेटफॉर्म के अनुरूप खोजी खबरें कैसे लिखें

विषम क्षेत्रों में स्वतंत्र पत्रकारों के मानसिक स्वास्थ्य का संकट

वेबसाइट में बदलाव पर नजर रखने और स्प्रेडशीट से टेक्स्ट खोजने के लिए उपकरण

यह कार्य लाइसेंस के अन्तर्गत है क्रिएटिव कॉमन्स एट्रिब्यूशन-नोडेरिवेटिव्स 4.0 अंतर्राष्ट्रीय लाइसेंस
क्रिएटिव कॉमन्स लाइसेंस के तहत हमारे लेखों को निःशुल्क, ऑनलाइन या प्रिंट माध्यम में पुनः प्रकाशित किया जा सकता है।
आलेख पुनर्प्रकाशित करें
यह कार्य लाइसेंस के अन्तर्गत है क्रिएटिव कॉमन्स एट्रिब्यूशन-नोडेरिवेटिव्स 4.0 अंतर्राष्ट्रीय लाइसेंस
अगला पढ़ें
15वीं ग्लोबल इन्वेस्टिगेटिव जर्नलिज्म कॉन्फ्रेंस की तारीखों की घोषणा के साथ वेबसाइट आरंभ
पिछले आयोजनों की तरह, जीआईजेसी27 में भी ग्लोबल शाइनिंग लाइट अवॉर्ड के विजेताओं को सम्मानित किया जाएगा। हर दो साल में दिया जाने वाला यह पुरस्कार खतरे, दबाव या कठिन परिस्थितियों में की गई उत्कृष्ट खोजी पत्रकारिता को मान्यता देता है।
जीआईजेसी27 में एक व्यापक फ़ेलोशिप कार्यक्रम भी होगा, जिसके ज़रिए ग्लोबल साउथ और अन्य क्षेत्रों के पत्रकार सम्मेलन में भाग ले सकेंगे। फ़ेलोशिप के लिए आर्थिक सहयोग से दुनिया भर में दीर्घकालीन असर पैदा करने में मदद मिल सकती है।
विभिन्न सोशल मीडिया प्लेटफॉर्म के अनुरूप खोजी खबरें कैसे लिखें
खोजी पत्रकारों के लिए यह एक बड़ी समस्या है। महीनों तक चली जटिल जांच को नए फॉर्मेट में कैसे बदलें? किसी गहन जांच को ऐसे स्वरूप में कैसे बनाएं, जो तेजी से स्क्रॉल करने वाले पाठक के लिए बना हो? ऐसा करते हुए रिपोर्टिंग की विश्वसनीयता को कैसे कायम रखें?
विषम क्षेत्रों में स्वतंत्र पत्रकारों के मानसिक स्वास्थ्य का संकट
संघर्ष इलाकों में काम करने वाले स्वतंत्र पत्रकारों पर शारीरिक खतरों के बारे में काफी जानकारी मौजूद है। लेकिन उन पर मानसिक असर के बारे में बहुत कम बात की गई है। ऐसी रिपोर्टिंग करने वाले ज़्यादातर स्वतंत्र पत्रकारों को बड़े मीडिया संस्थानों का समर्थन नहीं मिलता है। उन्हें अक्सर काउंसलिंग, बीमा या संपादकीय सहयोग के अभाव के कारण बुरे अनुभवों से गुज़रना पड़ता है। यह उनके मानसिक आघात (ट्रॉमा) का कारण बन सकता है।
वेबसाइट में बदलाव पर नजर रखने और स्प्रेडशीट से टेक्स्ट खोजने के लिए उपकरण
एआई-संचालित यह टूल पत्रकारों का समय बचाता है। यह एक ऑनलाइन पहरेदार की तरह काम करता है। यह टारगेट साइट्स पर नज़र रखता है। वेबसाइट में किसी बदलाव या अपडेट्स के बारे में अलर्ट भेजता है, जिनके बारे में शायद आपको पता भी न चल पाता।