
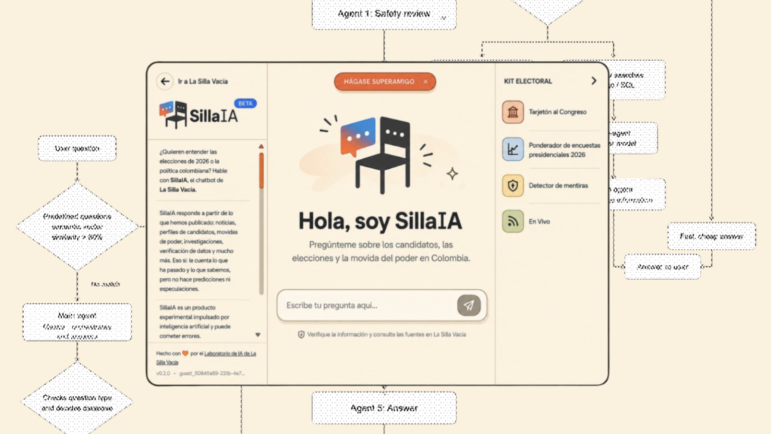
El chatbot con IA creado por La Silla Vacía. Imagen: captura de pantalla
Lo que aprendimos al crear un chatbot para el archivo de la sala de redacción de La Silla Vacía
Leer este artículo en
Guía para periodistas sobre cómo investigar criptomonedas
10 consejos prácticos para verificar afirmaciones científicas
Guía práctica para periodistas: colaboración con organizaciones de la sociedad civil y organizaciones no gubernamentales
Guía para reportajes sobre la rendición de cuentas de la IA
En La Silla Vacía, observamos cómo nuestra audiencia consume información y nos preguntamos cómo se alinea al tipo de periodismo que queremos hacer. En 2023, cuando el auge de ChatGPT comenzaba, este blog nos abrió la puerta para experimentar con OpenAI Playground y corregir el estilo de nuestras historias. Ese experimento nos dejó una lección que agradecemos haber aprendido a tiempo: lo que funcionaba en abril dejó de funcionar en mayo porque el modelo había cambiado sin previo aviso. La tecnología cambia constantemente, y eso modifica completamente la forma de abordar cualquier proyecto de IA.
En 2025, con un conjunto de herramientas internas que ya agilizaban la revisión de estilo, la creación de hilos en la red social X y la redacción de artículos en formato resumen, decidimos dar un paso más: un chatbot abierto a nuestra comunidad, alimentado por nuestro archivo de noticias. Lo lanzamos el 24 de junio de 2025. No teníamos certezas, solo preguntas que solo se podrían responder con el lanzamiento: cómo reaccionaría el público, cuánto costaría, si seríamos capaces de hacerlo, qué implicaría su mantenimiento. El 24 de junio de 2026, SillaIA cumplió un año. A continuación, contamos la trayectoria de esos 12 meses y lo que nos ha enseñado sobre lo que realmente significa dirigir una redacción en la era de la IA.
Empezando poco a poco, a propósito
Comenzamos incorporando el bot a tres secciones de nuestro sitio: Silla Nacional (la sección de noticias nacionales), En Vivo (la sección de noticias en vivo/de última hora) y Quién es Quién (nuestros perfiles de figuras políticas). Queríamos comprender de cerca a qué nos enfrentábamos. El hecho de que una misma pregunta pueda tener varias respuestas no es un asunto menor para un medio especializado cuya propuesta de valor es ofrecer el mejor periodismo independiente de Colombia. Necesitábamos saber cuánto variaban las respuestas y dónde radicaban los riesgos editoriales: en qué tipo de preguntas el sistema podría equivocarse de una manera que nos costaría caro.
Nuestro primer éxito fue un conjunto de datos de referencia: una hoja de cálculo con un conjunto fijo de preguntas y una columna de respuestas esperadas, que ejecutábamos cada vez que cambiábamos una pregunta, un modelo o un parámetro. La creamos manualmente, con columnas para fechas y modelos. Todavía no sabíamos cómo usar Google Colab. Tanto la idea de implementar un conjunto de datos de referencia como el uso de Colab surgieron de compartir el proyecto con nuestros compañeros, y por eso repetimos constantemente: «Cuando te enfrentes a un desafío, busca el apoyo de tu comunidad».
Para poner a prueba el modelo, formulamos preguntas difíciles a propósito. Cuando al equipo principal del proyecto se le acababan las ideas, acudíamos a los periodistas y les pedíamos preguntas sobre sus propias fuentes, del tipo que creían que la IA no podría responder. Se convirtió en un juego: quien consiguiera que fallara, ganaba.
Aun así, fueron los usuarios quienes descubrieron el primer fallo importante, no nosotros: nuestro sistema dependía demasiado de coincidencias literales y no estaba preparado para la forma en que la gente escribe en la vida real. Estábamos tan acostumbrados a que Google interpretara errores tipográficos, variantes y palabras similares que asumimos que cualquier motor de búsqueda podía hacerlo. Bastaba con que alguien escribiera con “i” un apellido que en nuestros archivos se escribe con “y” para que el sistema los tratara como dos personas diferentes. No se trataba de una pregunta mal formulada ni de un intento de confundirla: era simplemente la forma natural en que los usuarios escriben, y aun así la respuesta era errónea. Esto nos demostró que necesitábamos combinar la búsqueda semántica con mecanismos para reconocer errores ortográficos, variantes de nombres y diferentes maneras de expresar la misma pregunta.
Muy pronto descubrimos algo más que tampoco habíamos detectado en nuestras pruebas: los usuarios le preguntaban a SillaIA sobre nosotros, y no solo sobre política colombiana. Cómo tomamos decisiones editoriales, de dónde provienen nuestros fondos, cómo contactar a un periodista. Preguntas legítimas que no figuraban en nuestro archivo de noticias.
Dos sorpresas en pocas semanas, una misma conclusión: íbamos a tener que seguir añadiendo funcionalidades personalizadas, a un ritmo que no podíamos predecir.
La arquitectura que resistió el crecimiento
La arquitectura siempre fue modular, pero tuvo dos momentos clave: uno antes y otro después de configurar nuestras propias bases de datos y herramientas específicas para la búsqueda semántica.
La primera versión consistía en una cadena de pasos desconectados, ejecutados por agentes que no compartían suficiente contexto. Uno verificaba la seguridad de la pregunta, es decir, detectaba posibles intentos de alteración de mensajes: instrucciones con las que un usuario intentaba desviar al bot de su función, modificar su comportamiento u obtener información interna. Otro verificaba si existía una respuesta predeterminada: una respuesta que habíamos preparado con antelación para las preguntas frecuentes sobre La Silla Vacía o sobre SillaIA, cuya información no cambia significativamente con el tiempo.
Posteriormente, un tercer modelo clasificó la consulta: podía tratarse de una pregunta sobre un tema, el perfil de una persona, un asunto que La Silla no cubría o una solicitud que el sistema debía rechazar. En función de esta clasificación, se seleccionó la fuente a consultar. Otro agente realizó una búsqueda cíclica en la API de WordPress de La Silla Vacía, seleccionó el contenido más relevante y, finalmente, un último agente redactó la respuesta.
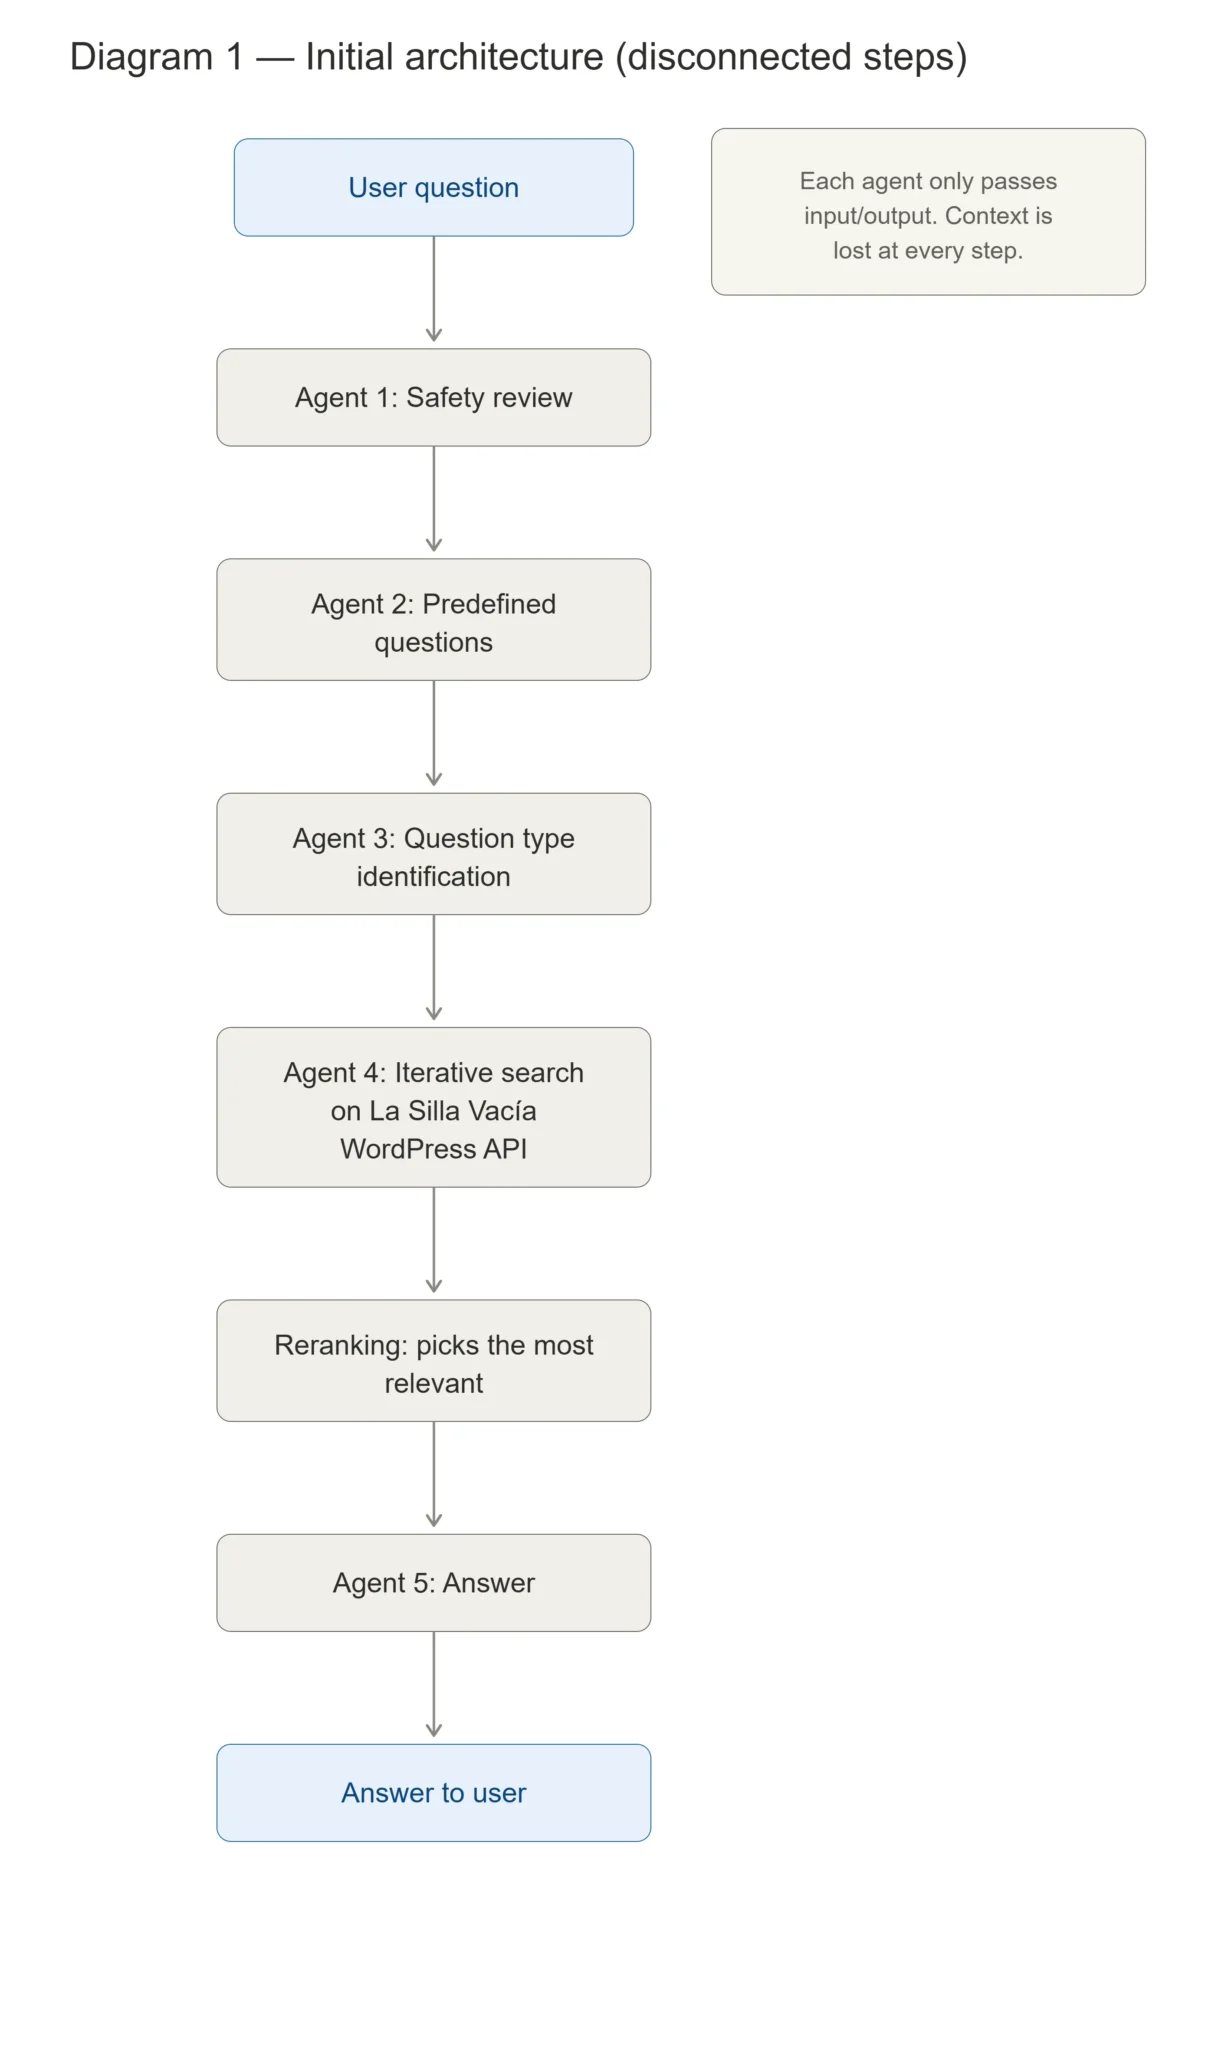
Imagen: Cortesía de Generative AI en el canal de noticias de Medium
La lógica de los pasos era correcta, pero implementarla con muchos agentes que solo se comunicaban entre sí mediante entradas y salidas generó problemas. El agente que identificaba el tipo de pregunta no proporcionaba suficiente contexto al agente que realizaba la búsqueda (solo el tipo y el texto original), por lo que en cada paso el siguiente agente perdía información. Era un proceso deficiente.
Decidimos dar el salto a la búsqueda semántica justo cuando los agentes autónomos comenzaban a ganar terreno. Cuando empezamos, los modelos de razonamiento apenas estaban en fase beta; seis meses después, ya eran una tecnología ampliamente aceptada. Ese salto nos brindó la oportunidad de rediseñar la lógica.
Mantuvimos la misma lógica subyacente (seguridad, respuestas predeterminadas, identificación de tipo, búsqueda iterativa con clasificación y respuesta), pero modificamos la distribución del trabajo. En lugar de modelos separados, cada uno con su propio contexto, configuramos la mayoría de los pasos como tareas para un único agente autónomo, que recurre a subagentes en casos específicos. Ambas versiones eran multiagente, pero pasamos de un esquema lineal, donde cada agente realizaba un paso y se lo pasaba al siguiente, a uno jerárquico, donde un agente principal gestiona la mayor parte del flujo y solicita ayuda a los subagentes para tareas específicas.
Para el entorno de ejecución, utilizamos Mastra, un marco de agentes estilo LangChain, desarrollado completamente en TypeScript y muy ligero. Lo elegimos porque el entorno de ejecución de Python no nos funcionó bien en Vercel. Mastra es independiente del modelo, lo que nos permitió probar muchos modelos y modificarlos rápidamente. Comenzamos las pruebas en Opus y luego implementamos GPT 5.1. Actualmente, utilizamos una combinación de GPT 5.4 con un alto nivel de análisis y esfuerzo para el agente principal y GPT 5.4 nano con la misma configuración para tareas específicas del proceso. Monitoreamos y modificamos constantemente los modelos, y el siguiente paso es evaluar un cambio a los modelos fronterizos de GPT 5.5 Sol y Luna.
El sistema consta de tres componentes: herramientas para realizar búsquedas, un agente principal que responde y coordina, y subagentes para búsquedas especializadas.
Antes de que el agente principal comience a operar, la pregunta pasa por un filtro independiente: el de respuestas predeterminadas. Resolverlas fuera del proceso del agente las hace mucho más rápidas y económicas: la respuesta correcta ya está escrita y no es necesario generarla de nuevo.
Si no hay coincidencia, el agente principal toma el control. Recibe la pregunta, la clasifica y, según su tipo, decide qué base de datos consultar. La regla de enrutamiento es sencilla: el agente consulta directamente la base de datos semántica de La Silla Vacía, alojada en Elasticsearch, que puede responder aproximadamente al 90 % de las preguntas.
Las búsquedas que requieren consultas más complejas en bases de datos como MongoDB o SQL se delegan a un subagente, casi siempre con un modelo más pequeño. Ahí es donde se encuentran, por ejemplo, los resultados históricos de elecciones, el directorio de periodistas de La Silla Vacía y la base de datos de candidatos al Congreso. Tras recibir la información de una herramienta o un subagente, el agente principal verifica que tiene todo lo necesario y elabora la respuesta.
Este análisis contextual permite que pasos que antes se realizaban por separado trabajen juntos de forma integrada. Por ejemplo, el filtro de seguridad ya no es un paso independiente, sino que forma parte de la verificación del tipo de pregunta que lleva a cabo el mismo agente. Esto permite que el agente, utilizando el contexto proporcionado por las herramientas, determine si una consulta es segura o no.
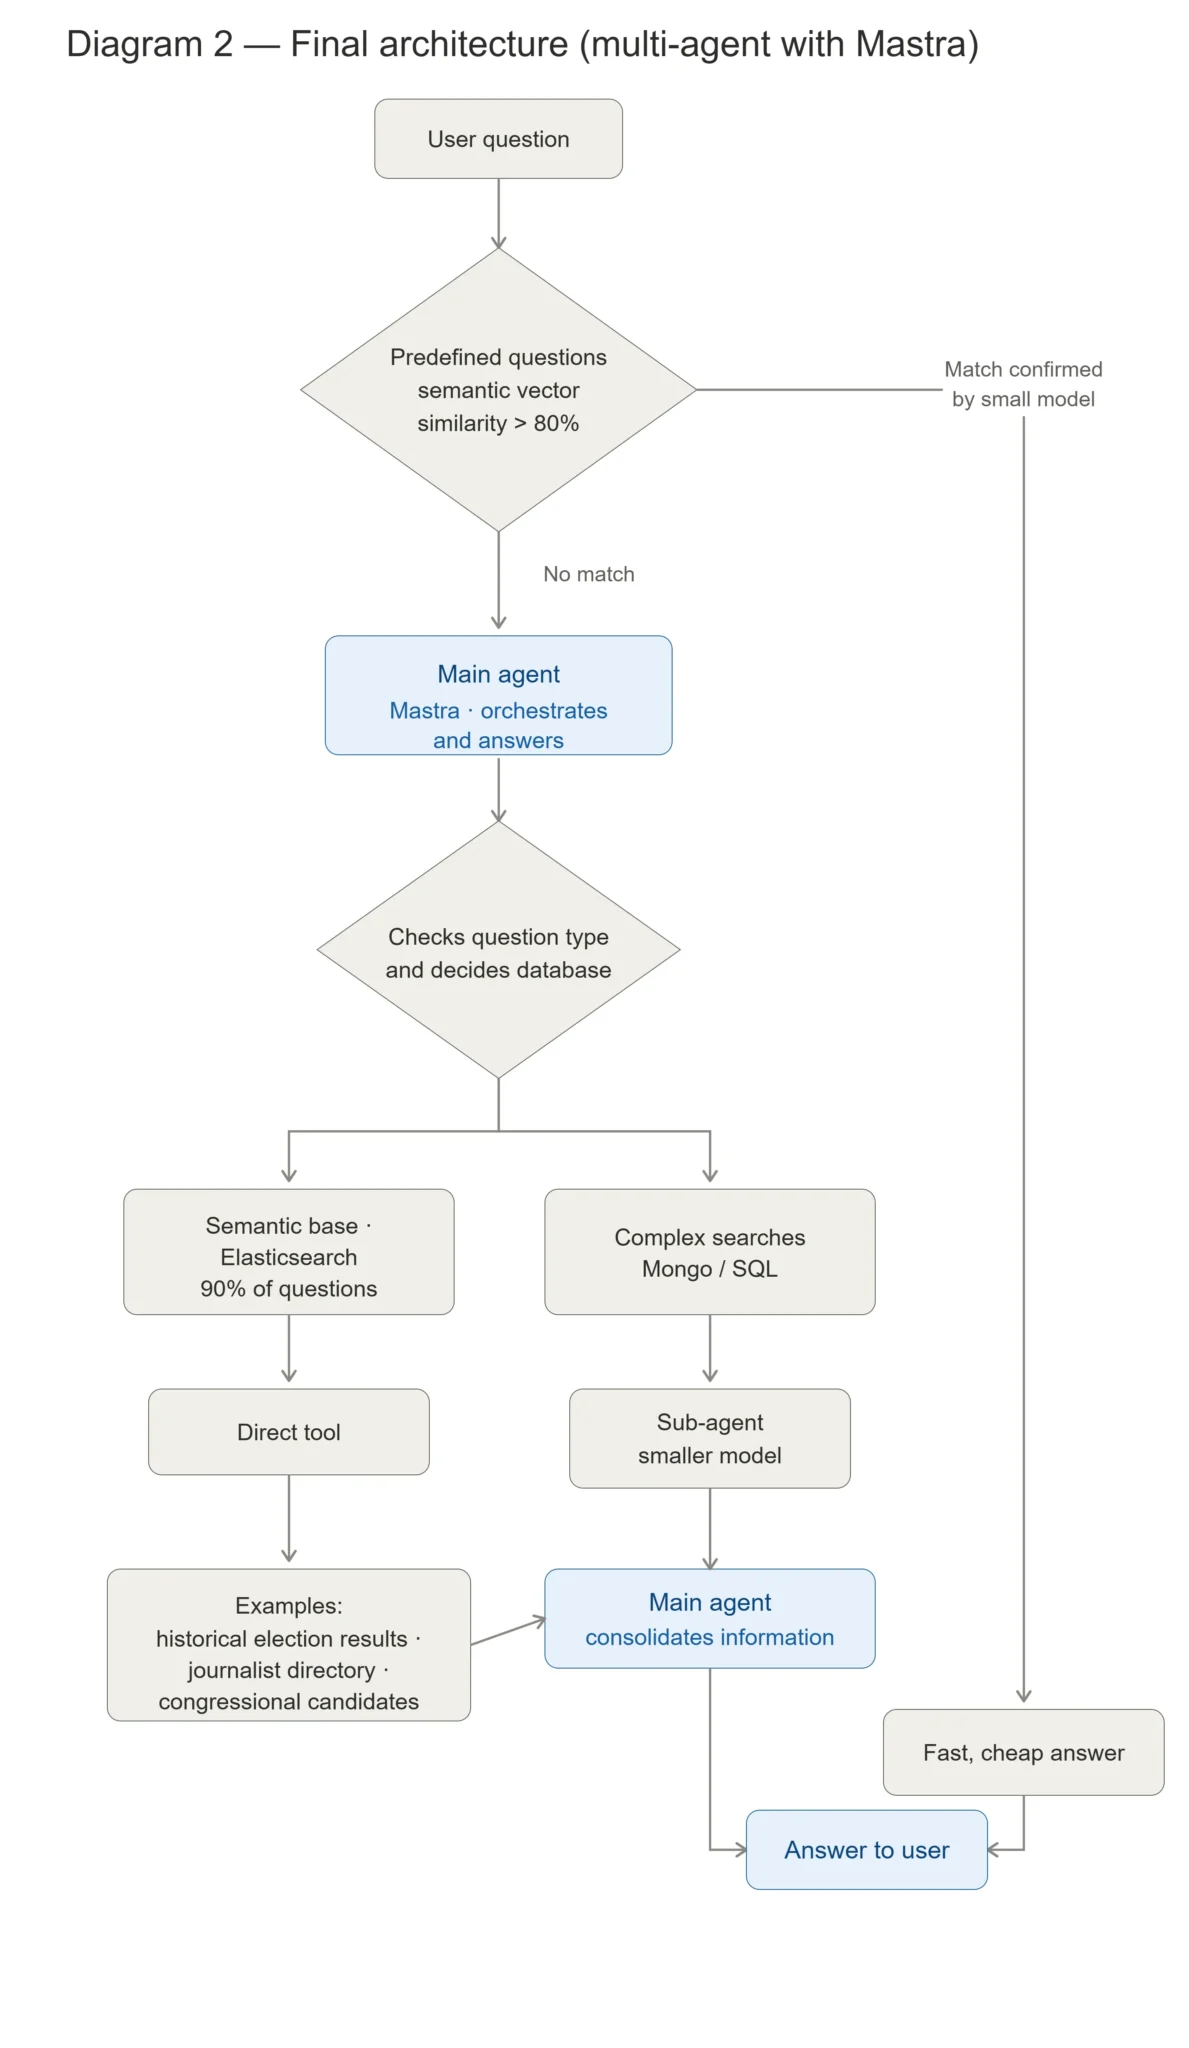
Imagen: Cortesía de Generative AI en el canal de noticias de Medium
La ventaja de este sistema, y de Mastra, es simple: añadir una fuente de datos implica crear la función, describir la herramienta y asignarla en el mensaje a los tipos de preguntas donde corresponda. Esto nos permite añadir y eliminar herramientas según la actualidad informativa: habilitamos una mientras un tema sea relevante y la desactivamos cuando deje de serlo.
La obsesión por medir
Un proyecto como este se sustenta en varias capas. En la base, un liderazgo que decidió apostar por él y mantenerlo en marcha. Encima, la infraestructura que lo hace posible. Y sobre ambas, sustentada en las dos, la rutina que le ha dado dirección este primer año: medir, sin descanso, desde el primer día.
Hacemos un seguimiento de cuántas interacciones recibimos, cuánto nos cuestan y, lo que es más revelador, qué preguntas nos hacen los usuarios. En sus primeros doce meses, SillaIA respondió 26 mil 11 preguntas de unos 20 mil usuarios únicos: un promedio de unas 2 mil 167 preguntas al mes. Nuestro día de mayor actividad fue el 21 de junio de 2026, la segunda vuelta de las elecciones presidenciales, con mil 20 preguntas en 24 horas, 14 veces más que en un día normal.
Esos números describen el tráfico. El tipo de pregunta describe al lector. Funciona como una brújula: nos muestra cómo la audiencia comprende el producto y orienta las decisiones sobre su desarrollo. Cada semana clasificamos las preguntas con IA y validamos los patrones manualmente. El responsable del proyecto revisa la hoja de cálculo, define las acciones a seguir y, mediante un código de colores, cada miembro del equipo puede identificar de un vistazo qué tareas requieren su atención.
Esa capacidad de escucha transforma el producto. Por ejemplo, con las elecciones legislativas a la vuelta de la esquina, observamos que los usuarios buscaban candidatos, listas numeradas y partidos, pero en nuestro calendario editorial los perfiles de los candidatos al Congreso aún tardarían semanas en publicarse. Para que nadie se fuera con las manos vacías, preparamos una base de datos básica con los candidatos al Senado y a la Cámara de Representantes, el partido al que pertenecían y su número de papeleta. La integramos como una herramienta temporal, que podríamos retirar una vez que pasara el momento de la noticia.
La noche de las elecciones legislativas nos deparó algo inesperado: los usuarios solicitaron a SillaIA resultados en tiempo real. No estábamos preparados. Sin embargo, la reiterada pregunta puso de manifiesto una carencia que podíamos subsanar para las elecciones presidenciales, y en la primera y segunda vuelta ofrecimos datos de recuento de votos en tiempo real, tanto a nivel nacional como departamental, con otra herramienta temporal habilitada para esos días.
No todo lo que añadimos fue temporal. Esa misma escucha nos llevó a integrar fuentes que permanecieron: el Detector de Mentiras (“Lie Detector”, nuestra sección de verificación de datos) y Silla Amazonía (nuestra sección sobre la región amazónica).
La escucha también cambia lo que informamos. Preguntas recurrentes se han convertido en artículos periodísticos como estos:
- Respuestas a las preguntas más importantes sobre las elecciones hechas a la SillaIA
- Respuestas a las preguntas más frecuentes sobre el recuerdo de votos hechos a la SillaIA
- Elecciones 2026: guía completa para votar este 8 de marzo
Registramos algunos de estos cambios en un registro público que creamos cuando el propio equipo señaló que era difícil estar al tanto de todo lo que modificábamos constantemente.
Cómo contuvimos los costos
Cuando empezamos, no sabíamos cómo calcular los costos de un proyecto como este. Hablamos con otras organizaciones que tenían proyectos similares para entender cómo los habían gestionado y elaboramos nuestras propias proyecciones: cuánto costaría si una parte de los lectores, o de los Superamigos (“Superamigos”, los miembros de nuestro programa de membresía), agotaran todas sus preguntas cada mes, o qué pasaría si alguien con malas intenciones quisiera agotar nuestros tokens en mitad de la noche.
De ahí surgieron los límites: 10 preguntas al mes para cualquier lector, 50 para Superamigos y una cuota aparte para periodistas, editores y el equipo que prueba el sistema. Además, se estableció un límite de gasto mensual en los LLM, con alertas al alcanzar ciertos umbrales, y un etiquetado específico de generación y consulta que nos ha permitido realizar un seguimiento del uso y el costo de cada paso del proceso y comprender los cuellos de botella.
Los diferentes niveles son una invitación a apoyarnos, sí, pero sobre todo una forma de avanzar dentro de un presupuesto limitado sin exponerse a una factura imposible.
El producto que nunca termina
En casi todos los programas informáticos existe una expectativa implícita: se compilan, se lanzan y luego entran en una fase de soporte ligero, mantenimiento de bajo costo y ajustes ocasionales. Con SillaIA, esa fase nunca llegó. Y ahora sabemos que nunca llegará.
Las actualizaciones de los modelos nos toman desprevenidos, casi siempre cuando menos lo esperamos. Un proveedor cambia una versión, deja de dar soporte a otra, modifica un precio o ajusta la respuesta del sistema. Lo peor no es la solución en sí, sino que esos cambios no se ajustan a ningún calendario. No podemos planificar en qué semana del trimestre tendremos que interrumpir lo que estábamos haciendo para adaptarnos a los cambios. Simplemente llegan, y no nos queda más remedio.
La consecuencia práctica es que SillaIA vuelve a empezar de cero cada vez que cambia algo que no controlamos. No es un producto que mantengamos, sino uno que rehacemos parcialmente una y otra vez. Esto cambia el cálculo de cuánto cuesta operar la IA en una redacción: el gasto no se limita a la infraestructura o a la factura mensual, sino que también implica mantener un equipo capaz de detectar a tiempo un fallo y solucionarlo antes de que un lector reciba una respuesta errónea sobre unas elecciones.
Agradecimientos
Este proyecto no habría sido posible sin el apoyo de la Fundación Konrad Adenauer (KAS) ni la participación activa de varios compañeros. Iván Montes, responsable técnico de La Silla Vacía, desarrolló la interfaz de usuario. Laura Torrado, editora de nuestro equipo, aportó su criterio durante todo el proceso. Y Juan Romero, del equipo de tecnología, colaboró en varias rondas de pruebas y configuró las preguntas predefinidas.
Nota del editor: Este artículo se publicó originalmente en el canal Generative AI in the Newsroom de Medium y se reproduce aquí con permiso.
 Karen De la Hoz es la responsable de IA en La Silla Vacía e imparte clases sobre nuevas tecnologías en la Universidad de Cartagena, Colombia. Además, dirige el canal Generative AI in the Newsroom en Medium y el blog Noches de Media, que explora la intersección entre periodismo, tecnología y sociología.
 Pablo Manrique es economista y científico de datos con experiencia en startups y consultorías, especializado en análisis de datos y desarrollo de inteligencia artificial. Utiliza inteligencia artificial y minería de datos para la redacción y el análisis, con especial atención a temas económicos. Además, es el desarrollador back-end de La Silla Vacia AI Lab.
Guía para periodistas sobre cómo investigar criptomonedas
10 consejos prácticos para verificar afirmaciones científicas
Guía práctica para periodistas: colaboración con organizaciones de la sociedad civil y organizaciones no gubernamentales
Guía para reportajes sobre la rendición de cuentas de la IA
“Como dicen, si tu madre te dice que te quiere, busca una segunda fuente”
Transformando la comunidad periodística, Parte I: Cómo las conferencias globales de GIJN han tenido impacto en todo el mundo
Lista la preventa de entradas para GIJC27: ¡Regístrate ahora!
Convocatoria abierta: Premios Global Shining Light en GIJC27

Esta obra está licenciada bajo un Creative Commons Reconocimiento-Sin Derivadas 4.0 Licencia Internacional
Republica nuestros artículos de forma gratuita, en línea o de manera impresa, bajo una licencia Creative Commons.
Republica este artículo
Esta obra está licenciada bajo un Creative Commons Reconocimiento-Sin Derivadas 4.0 Licencia Internacional
Leer siguiente
10 Preguntas
“Como dicen, si tu madre te dice que te quiere, busca una segunda fuente”
Cualquiera que haya seguido las noticias de Oriente Medio en los últimos años habrá oído hablar de Timour Azhari, cuyas premiadas investigaciones ayudaron a descubrir lo que estaba sucediendo en Siria tras la caída del antiguo régimen.
GIJN Impacto
Transformando la comunidad periodística, Parte I: Cómo las conferencias globales de GIJN han tenido impacto en todo el mundo
GIJN dio seguimiento a los testimonios detallados de cinco reporteros que han asistido a Conferencias Globales anteriores para comprender mejor y escuchar, en sus propias palabras, cómo estos eventos han impulsado su labor periodística.
GIJC27
Lista la preventa de entradas para GIJC27: ¡Regístrate ahora!
La Conferencia Global de Periodismo de Investigación de 2027 (#GIJC27) es organizada por la Red Global de Periodismo de Investigación (GIJN) y VVOJ, junto con sus socios regionales Journalismfund Europe y Free Press Unlimited.
GIJC27
Convocatoria abierta: Premios Global Shining Light en GIJC27
Este premio, patrocinado por GIJN, reconoce el periodismo de investigación realizado en un país en desarrollo o en transición, bajo amenaza, coacción o en las condiciones más extremas. La fecha límite para presentar solicitudes es el 28 de febrero de 2027.