
Note de la rédaction : Ce guide est le fruit d’une collaboration entre l’équipe « AI Accountability » du Pulitzer Center et de GIJN. Karen Hao, Laís Martins et Pablo Jiménez Arandia ont contribué à l’élaboration de certains des supports décrits dans cet article.
L’intelligence artificielle (IA) est devenue un acteur majeur dans de nombreux domaines de la société à travers le monde. Cette technologie joue un rôle prépondérant dans de nombreuses économies et a des répercussions sur les travailleurs du savoir à l’échelle mondiale. Les acteurs les plus puissants dans ce domaine sont une poignée d’entités basées pour la plupart aux États-Unis, en Europe ou en Chine, dont beaucoup sont des géants privés de la technologie qui ont levé des milliards d’investissement et sont en passe de donner le ton quant à la manière dont cette technologie sera développée et déployée à travers le monde.
Mais, de sa chaîne d’approvisionnement à ses applications, l’IA a également suscité de nombreuses controverses. Les centres de données nécessaires au développement de l’IA consomment des quantités extraordinaires d’eau et d’énergie. Les travailleurs chargés d’étiqueter les données dont l’IA a besoin sont confrontés à des salaires bas et à des problèmes de santé mentale. Les technologies d’IA elles-mêmes se sont révélées biaisées et susceptibles de produire des résultats erronés lorsqu’elles sont utilisées.
Le domaine de l’IA regorge de sujets que les journalistes d’investigation peuvent exploiter. Ce guide a pour but d’aider les journalistes à comprendre certains aspects techniques de la technologie sous-jacente à l’IA et de leur fournir un cadre leur permettant de l’analyser.
Qu’est-ce que l’IA ?
Beaucoup de gens ont découvert le concept d’intelligence artificielle grâce à ChatGPT. C’est pourquoi ils assimilent souvent ChatGPT à l’IA et l’IA à ChatGPT. Mais la réalité est bien plus complexe que cela. L’intelligence artificielle désigne le processus consistant à utiliser des machines pour imiter la prise de décision humaine ; il s’agit en réalité d’un terme fourre-tout qui englobe un grand nombre de technologies.
Les scientifiques et les chercheurs ont inventé ce terme dans les années 1950 et, depuis lors, ont trouvé de nombreuses façons différentes de reproduire l’intelligence humaine grâce à la technologie. L’une des méthodes d’IA les plus populaires et les plus prolifiques de nos jours est l’apprentissage automatique (“machine learning”), sous toutes ses formes, y compris ses sous-catégories que sont l’apprentissage profond (“deep learning”) et l’IA générative.
L’apprentissage automatique consiste à analyser des données afin d’identifier des modèles qui nous permettent de faire des prédictions ou de prendre des décisions sur la base de ces résultats. Ces analyses font appel à diverses méthodes mathématiques, allant de simples statistiques à des réseaux neuronaux complexes, souvent en fonction de la quantité de données traitées. Le résultat de cet apprentissage est un programme informatique, ou modèle d’IA, capable d’intégrer de nouvelles données et de formuler des prévisions ou de générer de nouvelles informations à partir de ces anciennes données. À bien des égards, on peut considérer les résultats de l’apprentissage automatique comme un « remix » d’anciennes données. Dans un cas d’utilisation concret, des modèles simples d’apprentissage automatique peuvent être utilisés par des organismes publics pour attribuer des scores de risque à des bénéficiaires potentiels de l’aide sociale ou à des personnes sollicitant des aides au logement.
L’apprentissage profond est un sous-ensemble de l’apprentissage automatique qui nécessite un volume considérable de données, souvent de l’ordre de plusieurs millions, et qui utilise des méthodes analytiques complexes, telles que les réseaux neuronaux — des méthodes mathématiques imitant la structure du cerveau et composées de nœuds interconnectés — pour donner du sens à ces données. (Pour en savoir plus sur les réseaux neuronaux, cliquez ici.) Ce type d’apprentissage automatique est souvent utilisé par les grandes entreprises technologiques, notamment pour prédire les termes recherchés dans les moteurs de recherche ou pour alimenter les systèmes de recommandation des services de streaming.
Il existe également l’IA générative, un sous-ensemble de l’apprentissage automatique qui nécessite encore plus de données et, pendant sa phase d’entraînement, encore plus d’énergie et des méthodes mathématiques complexes pour créer ses modèles. L’IA générative se distingue de nombreuses autres méthodes d’apprentissage automatique en ce qu’elle ne se contente pas de produire une recommandation pour un fil d’actualité ou un score prédictif, mais crée également du nouveau contenu sous forme de texte ou d’images. C’est cette technologie que nous rencontrons aujourd’hui à travers les grands modèles linguistiques (LLM) sous la forme de chatbots tels que ChatGPT ou Gemini, ainsi que par le biais d’applications qui créent des images à partir de consignes textuelles, comme Midjourney.
Le schéma ci-dessous présente toutes les versions de l’apprentissage automatique.
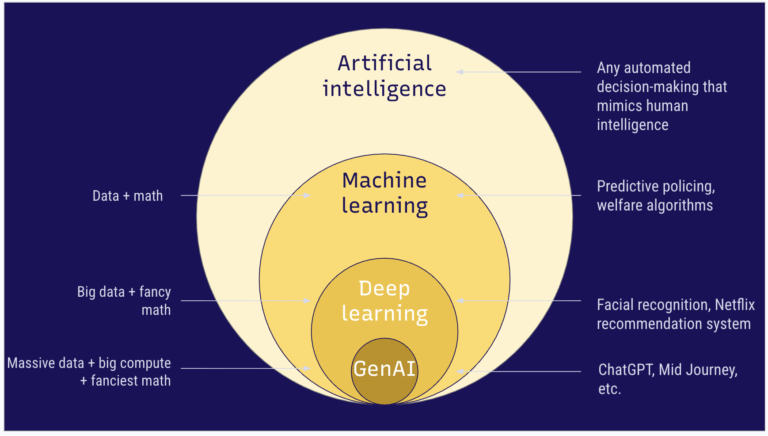
Représentation graphique de l’intelligence artificielle et de ses sous-domaines, notamment l’apprentissage automatique, l’apprentissage profond et l’IA générative. Image : avec l’aimable autorisation du Pulitzer Center.
Avoir une idée générale du fonctionnement de l’apprentissage automatique peut aider les journalistes à trouver des moyens d’aborder le sujet, à poser des questions éclairées sur cette technologie et à mieux exploiter les différentes étapes du développement de l’IA dans leurs enquêtes.
Cadre de référence pour les enquêtes sur la responsabilité en matière d’IA
Lorsque nous avons commencé à développer la série « AI Spotlight » avec Karen Hao, une question simple revenait sans cesse : qu’aurions-nous aimé savoir lorsque nous avons commencé à couvrir l’IA ? La réponse était un cadre de référence permettant d’identifier et de structurer les enquêtes sur l’IA.
L’IA englobe un large éventail de technologies et de enjeux, et il peut être difficile de savoir par où commencer. Notre cadre s’articule autour des quatre étapes du développement de l’IA moderne. À la base se trouvent les intrants, les données et la puissance de calcul qui rendent possibles les systèmes actuels. À partir de là, des modèles sont construits et entraînés, façonnés par les données et les choix de conception. Enfin, ces modèles sont appliqués dans le monde réel. Chacune de ces étapes de développement s’accompagne d’un ensemble propre d’enjeux, d’acteurs impliqués et de personnes ou de structures concernées.
Nous allons passer en revue chacune de ces étapes, en abordant les concepts clés et des exemples typiques.
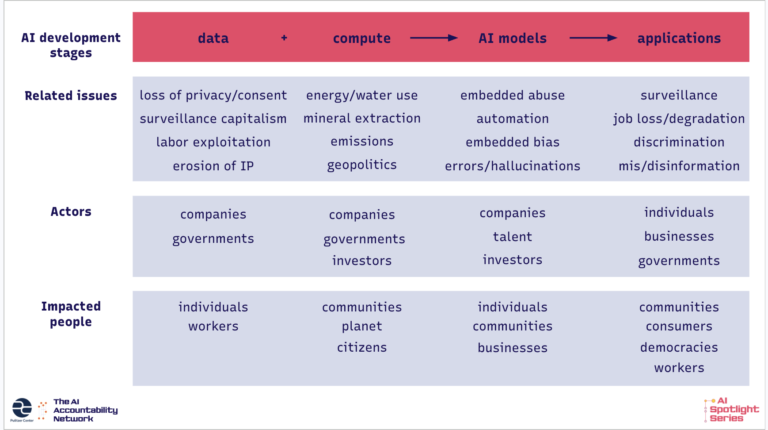
Capture d’écran : représentation graphique du cadre de reporting sur la responsabilité en matière d’IA, avec l’aimable autorisation du Pulitzer Center.
Enquêter sur les données utilisées
Les modèles d’IA les plus simples peuvent utiliser des ensembles d’apprentissage contenant quelques centaines de points de données, tandis que les modèles les plus complexes, comme les LLM, sont souvent entraînés à partir de vastes pans d’Internet. La diversité du contenu des données d’apprentissage peut être tout aussi large. Il peut s’agir de données structurées, sous forme de tableaux soigneusement organisés en lignes et en colonnes, ou de textes non structurés extraits de plateformes de réseaux sociaux, de sites d’actualités et de forums en ligne. De plus en plus, ces données comprennent également des images et des vidéos.
La plupart des enquêtes consacrés à la phase de développement des données ont tendance à se concentrer sur des systèmes plus avancés, entraînés à partir d’ensembles de données massifs à l’échelle industrielle. Un nombre important de ces articles aborde les questions de vie privée et de propriété intellectuelle. En particulier, la manière dont des contenus protégés par le droit d’auteur ou des données personnelles se retrouvent dans les pipelines d’entraînement des modèles d’IA. Cet article de The Atlantic, par exemple, examine comment Meta aurait utilisé des milliers de livres piratés pour entraîner son modèle d’IA générative Llama ; un porte-parole de Meta a refusé de commenter auprès des journalistes de The Atlantic, invoquant le litige en cours contre l’entreprise. Un autre article, publié par le New York Times, a révélé que des compagnies d’assurance automobile achètent des données personnelles de conduite provenant d’applications en apparence anodines afin d’évaluer le profil de risque des conducteurs.
Mais l’analyse des données implique également de prendre en compte le travail humain qui rend les ensembles de données d’entraînement utilisables en premier lieu. Alors que les entreprises ont tendance à présenter leur collecte de données et leur processus d’entraînement comme hautement automatisés, la réalité est que les ensembles d’entraînement sont souvent nettoyés et classés par une vaste classe défavorisée d’étiqueteurs de données, principalement situés dans les pays du Sud et travaillant par l’intermédiaire d’entreprises de sous-traitance et de plateformes de travail numérique. Ces travailleurs étiquettent des photos de chats et de chiens qui alimentent des classificateurs d’images, tracent des cadres autour d’objets dans des séquences de caméras embarquées utilisées pour entraîner des voitures autonomes, ou identifient les discours de haine et les contenus violents afin d’empêcher les modèles de langage de grande envergure (LLM) de les reproduire.
Des reportages réalisés aux quatre coins du monde ont montré que ces travailleurs des données sont exploités, sous-payés et parfois contraints de s’exposer à des contenus traumatisants. Cette enquête du Bureau of Investigative Journalism révèle comment des travailleurs indépendants faiblement rémunérés à travers le monde contribuent, à leur insu, à l’entraînement des systèmes de reconnaissance faciale utilisés par le gouvernement russe. Une autre enquête d’Africa Uncensored s’est penché sur le secteur en pleine expansion des « tuteurs IA », dans lequel des travailleurs hautement qualifiés entraînent des chatbots basés sur des grands modèles de langage (LLM) afin qu’ils produisent des réponses de meilleure qualité.
Enquêter sur la puissance de calcul
Une fois les ensembles de données d’entraînement collectés et nettoyés, les entreprises les utilisent pour entraîner des modèles d’IA. Alors que des modèles d’IA simples peuvent être entraînés en une fraction de seconde sur un ordinateur portable grand public, des modèles plus complexes, comme ChatGPT d’OpenAI, nécessitent d’énormes quantités de puissance de calcul. Cette puissance de calcul, souvent appelée « compute », est généralement fournie par des puces informatiques spécialisées hébergées dans d’immenses centres de données.
Les enquêtes consacrées à la phase de développement de la « puissance de calcul » ont tendance à se concentrer sur l’impact environnemental, social et économique de l’infrastructure physique tentaculaire et en pleine expansion qui alimente le développement moderne de l’IA. Lorsque nous avons lancé la série « AI Spotlight » en 2024, les centres de données constituaient encore un sujet relativement nouveau dans les reportages. Depuis lors, de nombreux reportages réalisés en Amérique latine, en Asie, en Afrique et aux États-Unis ont mis en évidence les quantités colossales d’énergie et d’eau consommées par les centres de données, ainsi que les efforts déployés par les entreprises ou les gouvernements pour dissimuler ces chiffres. Au Brésil, par exemple, Laís Martins, boursière Pulitzer, a découvert qu’un centre de données de TikTok était censé consommer autant d’électricité que 2,2 millions de personnes ; l’entreprise n’a pas répondu à la journaliste.
Les enquêtes consacrées aux centres de données ne se limitent pas à leur impact environnemental. Ils examinent également la manière dont ces centres transforment les communautés locales, les promesses de croissance économique souvent non tenues, ainsi que les efforts intenses de lobbying menés tant au niveau local que national pour les attirer et les construire. Laís et Pablo Jimenez Arandia ont élaboré une version adaptée de notre cadre analytique, axée spécifiquement sur les reportages consacrés aux centres de données, que vous trouverez ci-dessous.
Image: Avec l’aimable autorisation du Pulitzer Center.
Enquêter sur les modèles
La combinaison des données d’entraînement et de la puissance de calcul donne naissance à un modèle d’IA, un artefact technique capable de réaliser des prédictions, des classifications ou, dans le cas de l’IA générative, de créer du contenu entièrement nouveau. À l’instar des données et de la puissance de calcul, les modèles d’IA varient en termes de complexité et d’échelle, allant de systèmes d’apprentissage automatique relativement simples utilisés pour calculer les primes d’assurance maladie à des systèmes sophistiqués d’apprentissage profond capables de générer des images réalistes.
Les enquêtes consacrées aux modèles d’IA ont tendance à se concentrer sur les questions liées aux biais, aux erreurs ou aux effets néfastes de l’automatisation sur les communautés et les institutions.
Ces enquêtes peuvent examiner de près les choix de conception lorsqu’ils sont accessibles, tels que les données d’entraînement ou les paramètres utilisés par un modèle. Cette enquête d’El Confidencial, par exemple, a permis d’obtenir la formule d’un système d’IA utilisé dans le système pénitentiaire catalan pour prédire qui commettra un crime à l’avenir. Selon les journalistes, le modèle attribuait systématiquement des scores de risque plus élevés à certains groupes sur la base de facteurs discriminatoires ou non pertinents.
Lorsque ces informations ne sont pas disponibles, il est possible d’analyser les résultats du modèle à la place. Un article publié par Rest of World a analysé de manière systématique 3 000 images produites par MidJourney AI, un outil de génération d’images très populaire, et a révélé que le système reproduisait des stéréotypes grossiers sur diverses cultures. Selon les journalistes, l’entreprise n’a pas répondu à leurs demandes de commentaires. Une autre enquête, menée par le Centre philippin de journalisme d’investigation (PCIJ), a procédé à une ingénierie inverse des résultats algorithmiques de Grab, une application populaire de VTC, en collectant des milliers de devis de courses. Elle a révélé que Grab facturait systématiquement aux consommateurs des suppléments de trafic censés ne s’appliquer qu’aux heures de pointe. Dans une réponse écrite adressée au PCIJ, la filiale philippine de Grab a déclaré avoir « pleinement coopéré à l’enquête [du Land Transportation Franchising and Regulatory Board] » en participant aux audiences.
Enquêter sur les applications
Enfin, il est important que les journalistes se penchent sur la manière dont l’intelligence artificielle est mise en œuvre dans le monde réel. Lorsque la technologie d’IA ne fonctionne pas comme prévu ou présente des dysfonctionnements, de nombreuses personnes soumises aux décisions prises par des systèmes automatisés, tels que des algorithmes ou des applications d’IA générative, peuvent subir un préjudice.
Dans un article publié dans The Guardian, la journaliste Johana Bhuiyan a montré comment la dépendance excessive du gouvernement américain vis-à-vis des applications de traduction basées sur l’IA avait conduit un demandeur d’asile à rester bloqué pendant six mois dans un centre de détention de l’ICE. L’application, qui fonctionnait mal avec les langues peu prises en charge, traduisait mal ses propos, ce qui l’empêchait de communiquer efficacement avec qui que ce soit. Le DHS n’a pas répondu à la journaliste du Guardian.
L’enquête de Hera Rizwan sur l’utilisation de la reconnaissance faciale par le gouvernement indien a révélé que l’application utilisée par les fonctionnaires pour distribuer des rations alimentaires d’urgence ne reconnaissait pas certaines femmes enceintes ou allaitantes, car leurs visages avaient changé par rapport aux images datant de plusieurs années stockées dans les bases de données gouvernementales. Le ministère du Développement des femmes et des enfants n’a pas répondu aux questions de Hera Rizwan.
Le journalisme d’investigation sur la responsabilité de l’IA s’adresse à tous
Comme le montrent les exemples ci-dessus, notre cadre de référence en matière de responsabilité peut aider les journalistes à traiter le sujet de l’IA, quels que soient leur niveau d’expertise technique et leurs ressources. Les reportages peuvent être courts ou longs, mettre davantage l’accent sur l’aspect humain ou être d’une réalisation plus technique. Nous espérons que ces approches et ces exemples aideront d’autres journalistes à trouver leur propre approche locale du journalisme d’investigation sur la responsabilité de l’IA.
Ressources
- « Algorithmic Literacy for Journalists » : une ressource proposant des explications et d’autres outils destinés aux journalistes.
- Programme open source de la série « AI Spotlight » : propose des tutoriels vidéo, des cadres de référence et des présentations issues de l’initiative du Pulitzer Center visant à former les journalistes du monde entier à l’IA.
- Guide du journaliste pour détecter les contenus générés par l’IA
- Guide d’enquête sur les algorithmes des réseaux sociaux
Recherche
- Algorithmic Justice League: une organisation qui recense et analyse les préjudices causés par les algorithmes.
- AI Now Institute: un institut indépendant qui publie des travaux de recherche sur l’IA et la responsabilité algorithmique.
- Center for Democracy and Technology: une association à but non lucratif qui publie des rapports sur les libertés civiles à l’ère numérique.
- Data and Society: un organisme de recherche à but non lucratif axé sur la technologie, les données et les politiques.
- Algorithm Watch: une association à but non lucratif basée à Zurich et à Berlin.
- Privacy International: une association à but non lucratif basée à Londres.
- Derechos Digitales” : une organisation à but non lucratif de défense des droits numériques axée sur l’Amérique latine.
- African Digital Rights Network: une organisation panafricaine de défense des droits numériques.
 Gabriel Geiger est un journaliste d’investigation basé à Athènes, en Grèce, spécialisé dans les reportages sur la surveillance et la responsabilité algorithmique. Il est actuellement journaliste d’investigation chez Lighthouse Reports, une rédaction à but non lucratif basée aux Pays-Bas. Ses articles ont notamment été publiés dans WIRED, Le Monde, Der Spiegel et The Guardian.
 Lam Thuy Vo est une journaliste qui allie l’analyse de données au reportage de terrain pour examiner l’impact des systèmes et des politiques sur les individus. Elle est actuellement journaliste d’investigation chez Documented, une rédaction indépendante à but non lucratif qui se consacre au reportage avec et pour les communautés d’immigrés, et professeure associée en journalisme de données à la Craig Newmark Graduate School of Journalism. Auparavant, elle a été journaliste chez The Markup, BuzzFeed News, The Wall Street Journal, Al Jazeera America et Planet Money (NPR).
Guide pour enquêter sur les algorithmes des réseaux sociaux
Guide pour enquêter sur l’insécurité alimentaire
Guide du journaliste pour détecter les contenus générés par l’IA
Guide pour enquêter sur les entreprises chinoises en open source
Guide pour enquêter sur les algorithmes des réseaux sociaux
Guide du journaliste pour détecter les contenus générés par l’IA
“Le journalisme d’investigation va au-delà des chiffres”: Couvrir la santé et l’environnement en Côte d’Ivoire
Le scénario caché : comment bâtir la chronologie d’une enquête

Ce travail est sous licence (Creative Commons) Licence Creative Commons Attribution-NonCommercial 4.0 International
Republier gratuitement nos articles, en ligne ou en version imprimée, sous une licence Creative Commons.
Republier cet article
Ce travail est sous licence (Creative Commons) Licence Creative Commons Attribution-NonCommercial 4.0 International
Lire la suite
Ressource Guide
Guide pour enquêter sur les algorithmes des réseaux sociaux
Dans ce guide, GIJN propose des conseils, des techniques ainsi que des procédures optimales pour enquêter sur les algorithmes – et leurs impacts spécifiques – utilisés par les plateformes de réseaux sociaux des géants de la tech.
Ressource Guide
Guide du journaliste pour détecter les contenus générés par l’IA
Ce guide propose aux journalistes un nouvel outil de détection et sept techniques avancées pour repérer les contenus susceptibles d’être générés par l’IA.
Actualités et analyses Getting Started in Investigative Journalism
Le scénario caché : comment bâtir la chronologie d’une enquête
Si une hypothèse constitue le point de départ d’une enquête — la réponse provisoire à la question « que pensons-nous qu’il se soit passé ? » —, une chronologie et une carte des sources déterminent la marche à suivre pour vérifier cette réponse.